
Von Warnmeldungen zu Vorfällen
In einem Kubernetes -Cluster fällt ein Knoten aus! Innerhalb von 90 Sekunden hat der Alert Manager eine Knotenwarnung, ein Dutzend Pod-Warnungen, eine Handvoll Workload-Warnungen und eine Warnung auf Namespace-Ebene ausgelöst.
Das Incident-Tool eröffnet für jeden einzelnen Vorfall ein Ticket. Der Bereitschaftstechniker wird fünfzehn Mal wegen eines einzigen Problems benachrichtigt und behandelt jede Benachrichtigung so, als wäre es die erste, da das System nicht erkennt, dass diese Vorfälle miteinander zusammenhängen. Und das nun mal auf Dutzende von Kundenumgebungen hochgerechnet!
Die übliche Reaktion besteht darin, bessere Alarmregeln zu erstellen, die Schwellenwerte anzupassen oder weitere Hemmungsregeln hinzuzufügen. Das alles ist nützlich. Allerdings lässt sich damit allein das Problem nicht skalieren, da ein hohes Alarmvolumen nicht unbedingt auf fehlerhafte Regeln hindeutet.
Das ist ein Anzeichen dafür, dass jede Warnmeldung so behandelt wird, als verdiene sie dieselbe Reaktion. Das ist aber nicht der Fall! Unser Ziel lässt sich einfach formulieren: Ein Problem sollte zu einem Vorfall mit einer Benachrichtigung und einer zugehörigen Beschreibung führen.
Das Erste, was unsere Pipeline für das Incident-Management richtig hinbekommen muss, ist die Unterscheidung. Ein Alert ist ein Signal dafür, dass eine Bedingung erfüllt ist. Ein Incident ist eine Arbeitseinheit für einen Menschen.
Die meisten Tools fassen beides zusammen: eine Benachrichtigung und ein Ticket. Deshalb wird die Warteschlange unüberschaubar.
Warum das Zusammenfassen ähnlicher Warnmeldungen nicht funktioniert
Zunächst fassen wir Wiederholungen derselben Warnmeldung mit derselben eindeutigen ID zusammen. Dadurch werden offensichtliche Wiederholungen entfernt, bevor die aufwändigere, auf maschinellem Lernen basierende Bewertung beginnt.
Anschließend möchten wir möglicherweise Warnmeldungen gruppieren, die sich hinsichtlich Name, Namensraum oder Zeitpunkt ähneln. Das Problem ist, dass miteinander in Zusammenhang stehende Warnmeldungen oft überhaupt nicht gleich sind.
„NodeMemoryPressure“, „PodCrashLooping“ und „HighLatency“ haben unterschiedliche Namen, unterschiedliche Bezeichnungen und unterschiedliche Verantwortliche. Ein auf Ähnlichkeiten basierender Ansatz hält sie voneinander getrennt.
Was diese Warnmeldungen zu einem einzigen Vorfall macht, ist nicht ihr Erscheinungsbild, sondern ihr Auftreten: auf demselben Knoten, hinter demselben Dienst oder bei zwei Diensten, von denen einer den anderen aufruft.
Was fehlt, ist Struktur.
Ein Diagramm zur Umwelt
Zu diesem Zweck führen wir für jede Kundenumgebung ein Echtzeit-Topologie-Diagramm. Es basiert auf Metriken, die wir bereits erfassen:
- Knoten sind die Komponenten, bei denen es zu Ausfällen kommen kann: Knoten, Pods, Dienste, Workloads, Ingresses, Volumes usw.
- Kanten sind die Wege, über die sich Fehler ausbreiten.
Eine Warnmeldung im Diagramm darstellen
Eine Warnmeldung ist lediglich eine Sammlung von Bezeichnungen. Es wird nie angegeben, wohin sie gehört. Deshalb verwenden wir eine Zuordnungsfunktion:
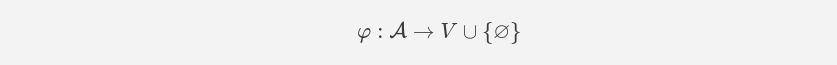
Dabei ist A die Menge der eingehenden Warnmeldungen und V die Menge der Topologie-Knoten. φ ist eine geordnete Kette einfacher Matcher, und der erste, der einen Knoten findet, gewinnt:
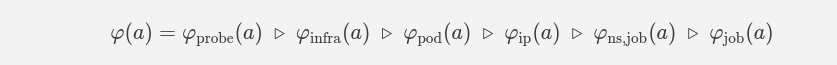
Einfacher ausgedrückt bedeutet „x ▹ y“: „Verwende x, wenn etwas gefunden wurde, andernfalls versuche es mit y“. Die Reihenfolge reicht vom spezifischsten bis zum allgemeinsten Hinweis.
Wenn φ(a) = ∅ ist, wird die Warnmeldung zu einer „Waisenmeldung“. Sie wird weiterhin als eigenständiger Vorfall weitergeleitet. Wir geben lediglich nicht vor zu wissen, wo sie ihren Ursprung hat.
Nach Verbindung gruppieren
Sobald die Warnmeldungen im Graphen dargestellt sind, stellt sich die Frage: „Welche Warnmeldungen stehen miteinander in Verbindung?“ Wir erstellen einen Teilgraphen, der ausschließlich die Warnmeldungsknoten V_A enthält – und fügen dann eine Kante zwischen zwei davon hinzu.

Anschließend ermitteln wir die schwach zusammenhängenden Komponenten von (V_A, E_A). Die wichtigste Kennzahl ist die Kompression:
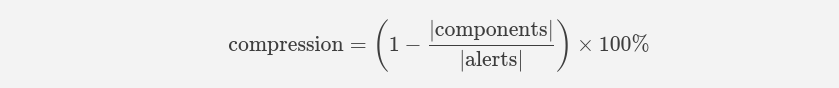
Wenn aus fünfzig Warnmeldungen zwei Komponenten werden, sind das 96 % weniger, was ein Mensch im Blick behalten muss.
Das System vermitteln
Durch die Gruppierung erfahren wir, welche Warnmeldungen zusammengehören. Sie sagt uns jedoch nicht, wie wichtig sie sind. Hier kommt maschinelles Lernen ins Spiel.
Wir wandeln jede Meldung in einen kanonischen Satz um. Auf diese Weise lernt das Modell aus dem Inhalt der Meldung. Dieser Text durchläuft einen Satz-Encoder:
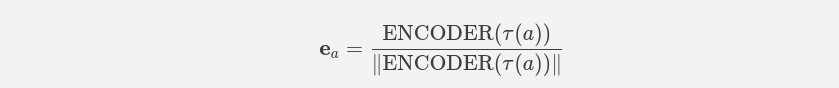
Dabei ist τ der Kanonisierungschritt und eₐ ein Einheitsvektor in einem N-dimensionalen Raum. Warnmeldungen mit ähnlicher Bedeutung werden nahe beieinander platziert, auch wenn ihre Bezeichnungen voneinander abweichen.
Auf den Einbettungen basieren zwei histogrammbasierte Boosting-Klassifikatoren. Sie lassen sich schnell trainieren, sind kostengünstig im Betrieb und können dichte Einbettungsmerkmale ohne großen Feineinstellungsaufwand verarbeiten.
Ein Klassifikator gibt jedoch immer eine Antwort zurück, auch bei Warnmeldungen, die ihm bisher noch nie begegnet sind. Daher erhält jede Vorhersage zusätzlich einen Konfidenzwert: Er gibt an, wie nah der Vektor an dem nächstgelegenen Beispiel liegt, mit dem das Modell trainiert wurde.
Anschließend betrachten wir für eine gesamte Komponente C die Gruppe als Ganzes. Wir bilden den Mittelwert der Einbettungen der Elemente und führen eine erneute Normierung durch:
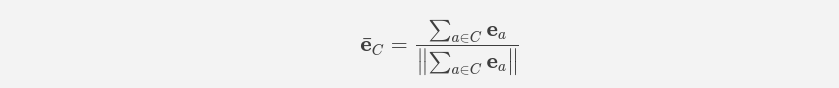
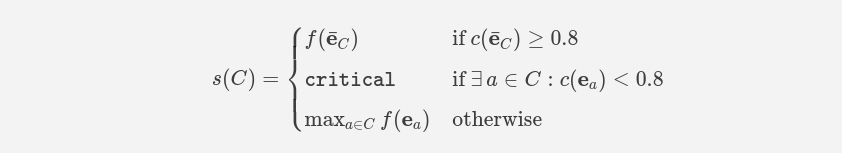
Dann beträgt der Schweregrad der Komponente:
Grundursache und Auswirkungen
Eine Gruppe miteinander verknüpfter, vertraulicher Warnmeldungen ist weitaus nützlicher, wenn sie mit einer Hintergrundgeschichte einhergeht.
Jedem Mitglied wird eine Rolle zugewiesen:
- Grundursache: Die Warnmeldung mit der höchsten Priorität auf der Ursprungsseite. Das ist der „Ausgangspunkt“.
- Direkte Auswirkung: Andere Warnmeldungen, die denselben Ursprung haben.
- Ausgebreitete Auswirkungen: Alles, was sich stromabwärts befindet und erreicht wird, wenn man den Graphen von der Wurzel aus nach außen durchläuft.
Die Priorität wird zunächst nach Stufe, dann nach Schweregrad und schließlich nach Startzeit geordnet.
Bei weitergeleiteten Warnmeldungen erklären wir anhand einer Suche nach dem kürzesten Weg von der Wurzel aus, wie es zu dem Fehler gekommen ist. Jeder Hop kostet einen hohen konstanten Wert zuzüglich eines geringen Gewichts für den Beziehungstyp.
Von Komponenten zu Vorfällen
Die Komponenten werden kontinuierlich neu berechnet, und es gehen ständig neue Warnmeldungen ein und werden wieder zurückgesetzt. Die Schwierigkeit besteht darin, eine stabile Identität aufrechtzuerhalten: Der Vorfall um 03:04 Uhr und der Vorfall um 03:09 Uhr müssen dasselbe Ticket sein.
- Zeitpunkt: Wir lösen nicht bereits bei der ersten Warnmeldung aus. Eine Warnserie erhält ein kurzes Abwartungsfenster, damit sich die Komponente bilden kann, und dieses Fenster ist kürzer, wenn bereits eine kritische Warnmeldung vorliegt. Danach führen wir in regelmäßigen Abständen eine erneute Korrelation durch – oder sofort, falls die Anzahl der Warnmeldungen stark ansteigt.
- Zuordnung: Eine neue Komponente wird einem offenen Vorfall zugeordnet, indem die darin enthaltenen Alarm-Fingerabdrücke anhand eines Überlappungskoeffizienten verglichen werden:
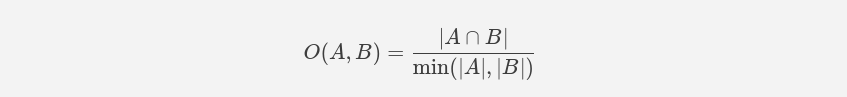
- Zusammenführung: Wenn eine Komponente zwei offene Vorfälle überlappt, hat sie diese miteinander verknüpft: Zwei Ausfälle, die zunächst unabhängig voneinander schienen, hatten letztendlich doch eine gemeinsame Ursache. Sie werden zu einem einzigen Vorfall zusammengefasst, wobei der älteste Vorfall erhalten bleibt. Das ist der Vorfall, den die Mitarbeiter bereits geprüft und kommentiert haben.
- Deduplizierung: Jede Überarbeitung wird anhand der tatsächlich relevanten Faktoren identifiziert: Schweregrad, Grundursache, Beteiligte und deren Rollen sowie betroffene Dienste. Zeitstempel und Konfidenzschwankungen werden dabei außer Acht gelassen. Wenn sich nichts Wesentliches geändert hat, wird nichts veröffentlicht. Ohne diese Vorgehensweise würde das Ticket während des gesamten Ausfalls jede Minute denselben Kommentar erhalten.
- Abschluss: Sobald sich alle an einem Vorfall beteiligten Mitglieder erholt haben, wird dieser automatisch als gelöst markiert. Das Ergebnis wird als ein zusammenhängender Vorfall ausgegeben und zu einem Jira- oder GLPI-Ticket mit einer einzigen Benachrichtigung zusammengefasst.
RCA-Rückmeldung
Die Korrelation beantwortet die Frage „Was ist gleichzeitig passiert?“. Die Ursachenanalyse beantwortet die Frage „Warum?“.
Jeder korrelierte Vorfall wird an unsere KI-gestützte RCA weitergeleitet. Die RCA geht von der Triage-Beschreibung aus und nicht von einer Liste mit Rohdaten der Warnmeldungen.
Anschließend fällen die Ingenieure ein Urteil über die RCA: bestätigt, teilweise bestätigt oder abgelehnt.
Der nächste Schritt besteht darin, diese in Trainingssignale umzuwandeln. Eine abgelehnte Grundursache oder ein Vorfall, den ein Techniker um 3 Uhr morgens herabgestuft hat, weil er bis zum Morgen hätte warten können, wird dann zur erneuten Einarbeitung weitergeleitet – jeder überprüfte Vorfall trägt dazu bei, dass der nächste umso genauer wird!
Lärm in eine Geschichte verwandeln
Wenn ein Cluster ausfällt, brauchen die Techniker nicht fünfzig Einzelheiten desselben Fehlers – sie brauchen den Gesamtzusammenhang.
Indem wir Rohdaten aus Warnmeldungen in ein Echtzeit-Diagramm einordnen, verankern wir verrauschte Signale in tatsächlichen Systemzusammenhängen statt auf Vermutungen zu stützen. Maschinelles Lernen beschleunigt diesen Prozess, indem es die Dublettenbereinigung, die Schweregradbewertung und die Auswirkungspfade übernimmt – und dabei jede Entscheidung transparent und nachvollziehbar hält.
Der Nutzen zeigt sich sofort: radikale Geräuschreduzierung, sofortige Klarheit und menschliches Feedback, das direkt in den Lernprozess einfließt, sodass jeder Vorfall klarer wird als der vorherige.
Bei der automatisierten Triage geht es nicht darum, Komplexität in einer „Black Box“ zu verbergen. Es geht vielmehr darum, aus 15 zusammenhanglosen Seiten eine einzige, umsetzbare Geschichte zu machen. Auf diese Weise können Bereitschaftsteams weniger Zeit damit verbringen, den Kontext zusammenzusetzen, und mehr Zeit damit, das eigentliche Problem zu beheben.
Behaltet die ITGix-Blogs im Auge – dort erscheint bald das nächste Kapitel!

